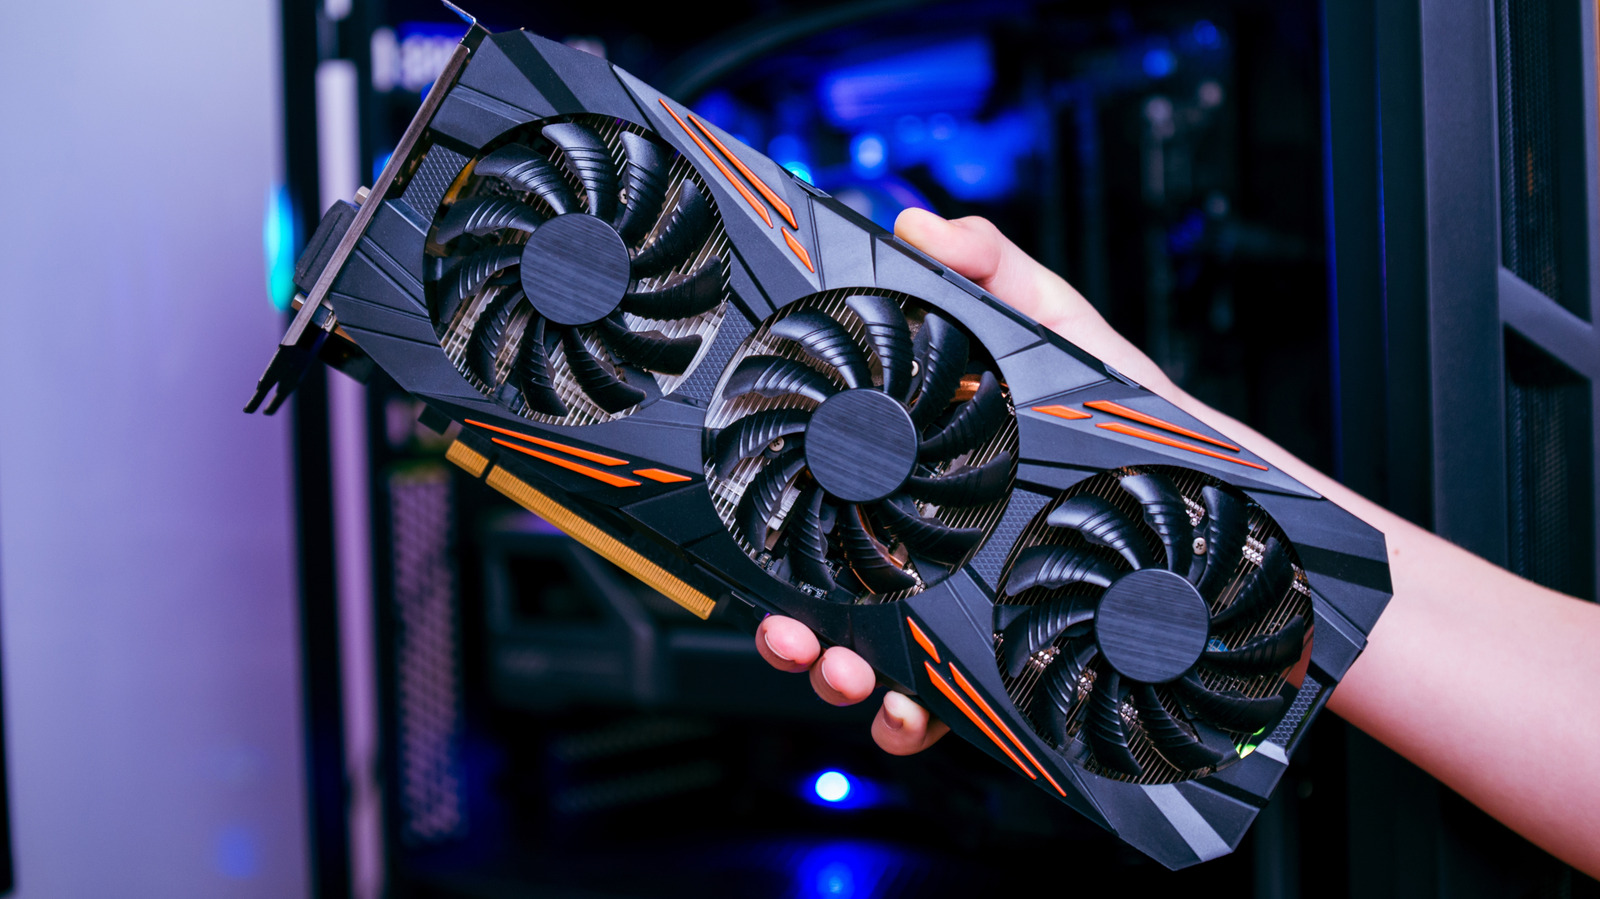
在个人电脑上本地运行大型语言模型正变得越来越容易,Ollama和LM Studio等工具简化了这一过程。然而,这些本地模型的性能和能力在很大程度上取决于用户的硬件,特别是RAM和VRAM。虽然16GB的RAM可以处理较小的模型(约70-80亿参数),但更强大的模型需要至少32GB的RAM和16GB的VRAM,这可能会很昂贵。文本生成速度更多地受内存带宽而非处理能力的影响,像Nvidia RTX 5090这样的高端GPU比CPU或NPU提供显著更快的性能。 AI
影响 运行本地AI模型需要大量的硬件投入,性能直接与RAM和VRAM容量挂钩。
排序理由 文章讨论了本地运行AI模型的工具和硬件,而非新的模型发布或前沿研究。
- Alibaba Group
- Apple Inc.
- ChatGPT
- Claude
- Gemma 3:27B
- GPT OSS 20B
- Large Model Systems Organization
- Llama-3.1:8b
- Llama 3.3-70B
- llama.cpp
- LM Studio
- Meta
- Microsoft
- Nvidia
- Ollama
- OpenAI
- Phi-4
- Qwen3_8B
- RTX 5090
AI 生成摘要 · Google Gemini · 来自 1 个来源。 我们如何撰写摘要 →