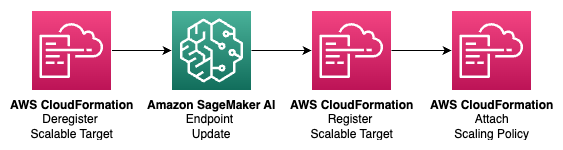
一种在 Amazon SageMaker AI 上自动扩缩容语音合成 (TTS) 模型的新方法旨在消除设置扩缩容目标的猜测。该方法以 Kokoro-82M 模型为例进行了演示,它用实例最大并发量(在 SLO 发生违规前)(Q_max) 和端到端扩缩容时间 (T_total) 的测量值取代了任意值。通过从这些指标推导扩缩容阈值和冷却时间,该解决方案可确保更有效的资源利用率并更好地遵守延迟服务级别目标。 AI
影响 提高了 SageMaker 上 TTS 模型部署的效率和可靠性,降低了成本并防止了延迟问题。
排序理由 博客文章,详细介绍了优化现有 AI 平台 (Amazon SageMaker) 中特定功能(自动扩缩容)的技术解决方案。
在 AWS Machine Learning Blog 阅读 →
- Amazon SageMaker
- AWS
- AWS Cloud Development Kit
- ConcurrentRequestsPerModel
- ISTFTNet
- Kokoro-82M
- Text To Speech
- StyleTTS2
AI 生成摘要 · Google Gemini · 来自 5 个来源。 我们如何撰写摘要 →