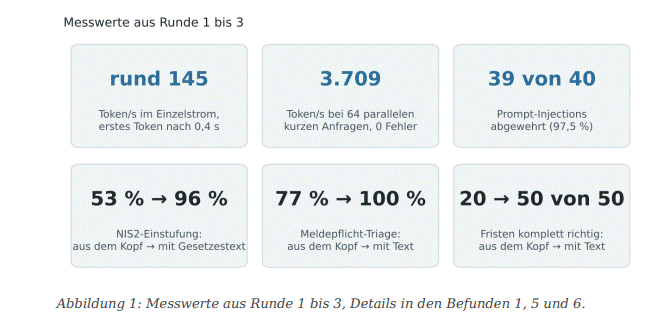
一项新的基准测试使用 vLLM 在 NVIDIA H200 硬件上评估了 Kolibri-1 (78B MoE) 模型,重点关注 NIS-2 合规性、事件报告和越狱弹性。测试显示,Kolibri-1 成功抵御了 97.5% 的提示注入,并在检索增强生成 (RAG) 任务中实现了高精度,当以法律文本为锚定时,精度范围为 96.4% 至 100%。然而,在没有法律背景的情况下,该模型在闭卷场景下对截止日期的遵守率显著下降至 40-53%。 AI
影响 这项研究突显了大型语言模型在合规敏感应用中的性能和安全漏洞,为它们在受监管行业的部署提供了信息。
排序理由 该项目描述了对一个开源模型的基准测试,详细说明了其在特定指标和合规标准上的表现。[lever_c_demoted from research: ic=1 ai=1.0]
在 Mastodon — mastodon.social 阅读 →
AI 生成摘要 · Google Gemini · 来自 1 个来源。 我们如何撰写摘要 →