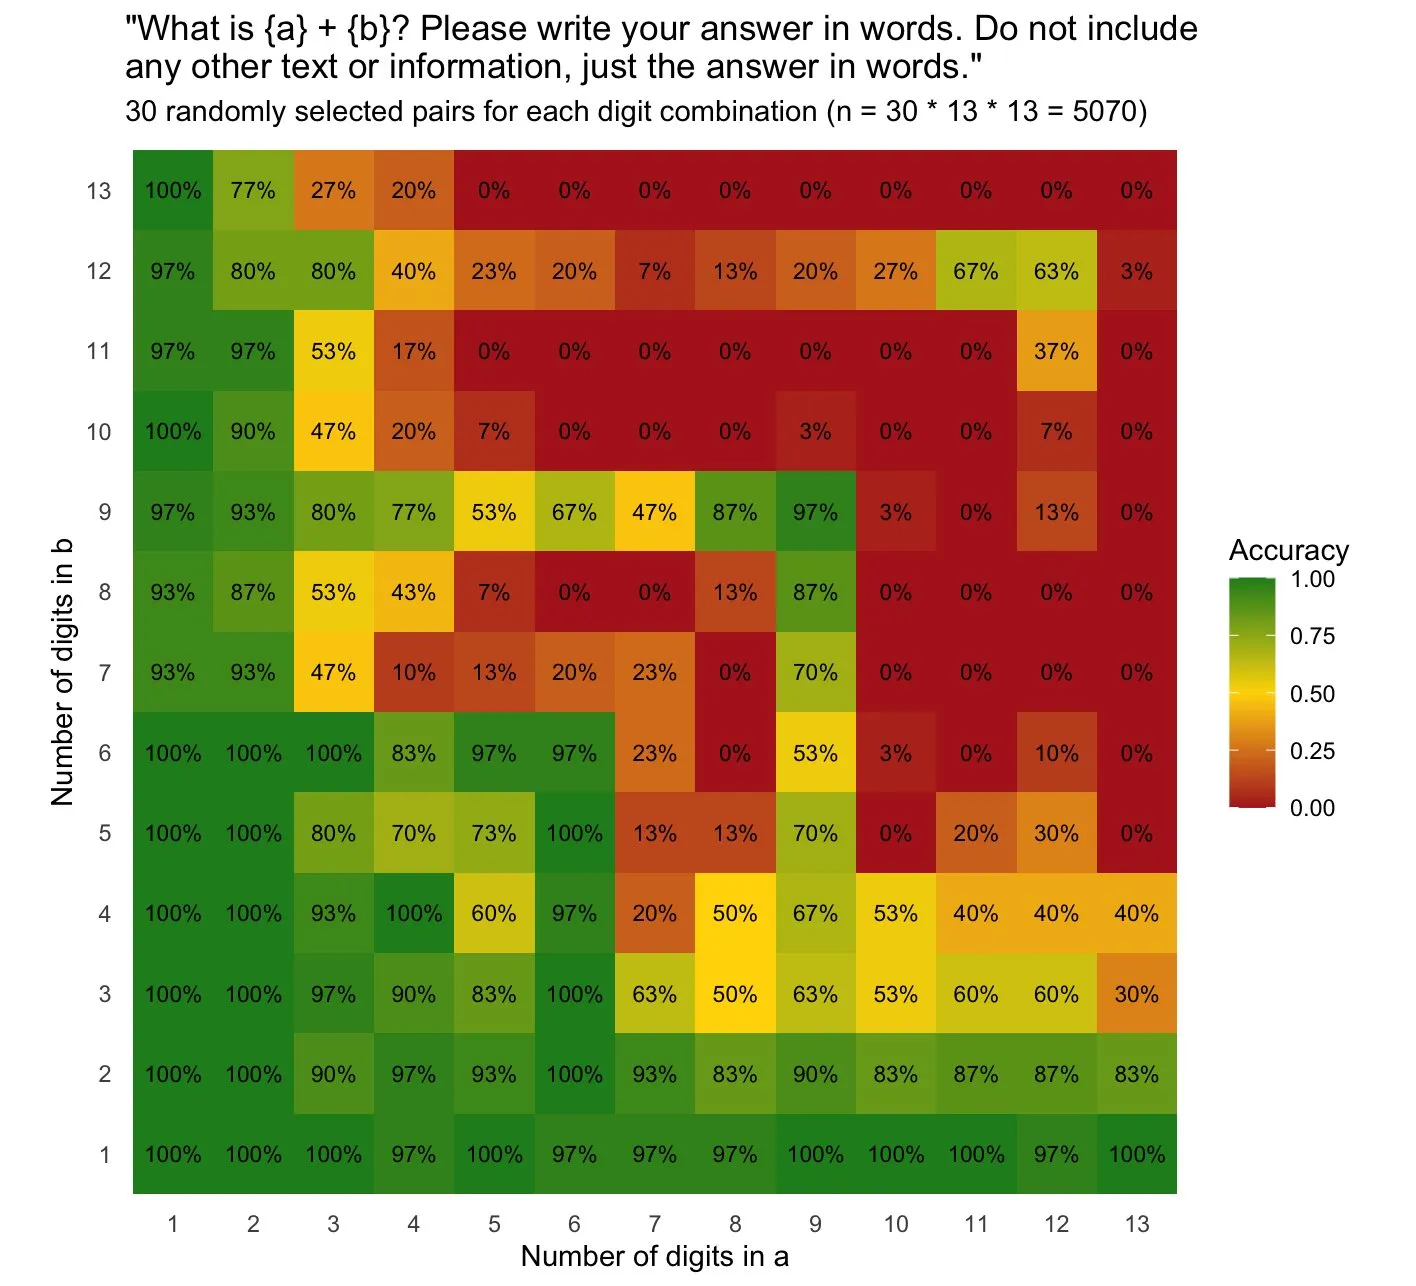
Simon Willison 记录了一项实验,比较了不同 AI 模型执行加法并将结果以文字形式表达的能力。最初受到两年前 GPT-4o 测试的启发,Willison 使用 Qwen3.8 27B 在本地硬件上重新进行了实验。Qwen3.8 模型表现出高度的准确性,在启用推理的情况下,169 次一次性尝试中有 167 次回答正确。 AI
影响 展示了大型语言模型在数值推理和基于文字的输出能力方面的提升。
排序理由 该集群详细介绍了一项比较 AI 模型在特定任务上能力的实验,符合研究类别。
- Bluesky
- Codex Remote
- Colin Frasier
- DGX Spark
- GPT-4o
- GPT-6 Astra
- OpenAI DevDay 2026
- Qwen3.8
- Qwen3.8-27B-Q4_K_M.gguf
- Simon Willison
AI 生成摘要 · Google Gemini · 来自 2 个来源。 我们如何撰写摘要 →