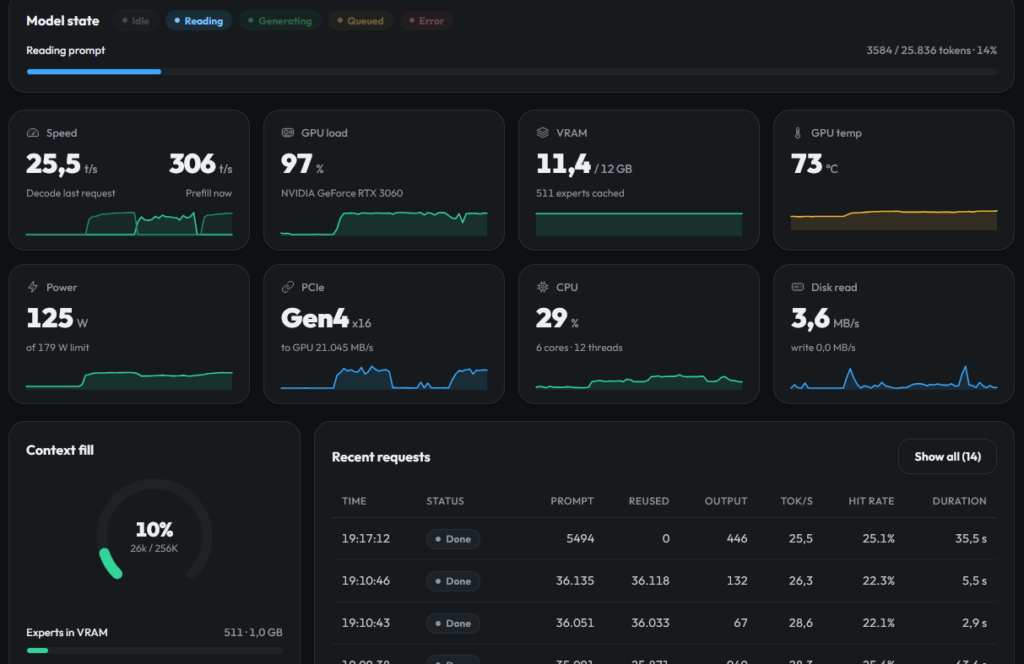
Strata 项目可在包括 12GB 显存的 GPU 在内的消费级硬件上本地运行 Qwen3.8-Flash-Next 等大型语言模型。它通过将模型的负载分配到 GPU、CPU、RAM 和 SSD,并利用专家混合(Mixture of Experts)架构,仅激活每个 token 所需的组件来实现。在 RTX 3060 上的初步测试显示,生成速度约为每秒 30 个 token,缓存利用率高,使其成为本地编码任务的可行选项。 AI
影响 使得大型模型能在消费级硬件上本地运行,可能减少对云端推理进行编码任务的依赖。
排序理由 文章描述了一个可在消费级硬件上运行现有 LLM 的项目,而非新的模型发布或重大的行业转变。
在 Mastodon — mastodon.social 阅读 →
- Anthropic
- GeForce RTX 3060
- ISTA-DASLab
- Linux
- LiveCodeBench V6
- Mastodon
- Microsoft Windows
- mixture of experts
- OpenAI
- OpenCorporates
- programmer
- Qwen3.8-Flash-Next
- Strata
- SWE-bench Verified
AI 生成摘要 · Google Gemini · 来自 1 个来源。 我们如何撰写摘要 →