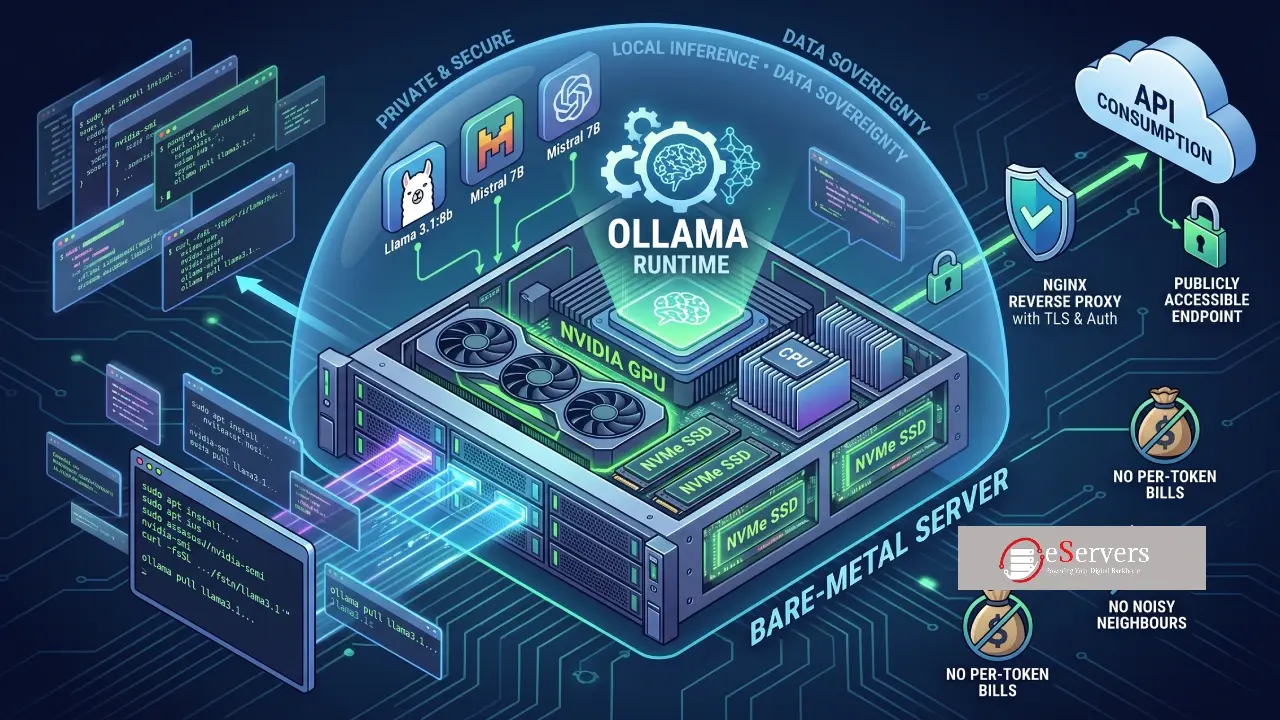
该帖子提倡通过在裸金属GPU服务器上使用Ollama在本地运行开源大型语言模型(LLM)来增强AI数据隐私。这种方法旨在最大化VRAM利用率,并避免与虚拟机管理程序相关的开销。作者还提供了在Ubuntu Linux上安全部署的教程。 AI
影响 通过在本地运行模型,使用户能够控制敏感的AI数据,绕过外部API风险。
排序理由 该项目讨论了一个用于在本地运行LLM的工具(Ollama),这是一个特定的应用程序,而不是核心AI发布或重要的行业事件。
在 Mastodon — mastodon.social 阅读 →
AI 生成摘要 · Google Gemini · 来自 1 个来源。 我们如何撰写摘要 →